エンティティSEOとは、会社・人物・製品・概念を「どの実体か」まで明確にし、検索エンジンや読者が混同しにくい情報設計にする考え方です。LLMOでも土台になる考え方ですが、構造化データや外部プロフィールを整えただけで、検索順位やAI回答への引用が保証されるわけではありません。
この記事では、Googleが公開しているKnowledge GraphとOrganization構造化データの説明を基に、エンティティの確認方法、SEO・LLMOで共通する整備の優先順位、効果の測り方を解説します。先に結論を言うと、登録先を増やすことではなく、公式情報と第三者情報の矛盾をなくすことが出発点です。
自社の表記ゆれ、構造化データ、外部掲載をどこから直すべきか迷う場合は、現状の確認からご相談ください。
エンティティSEOとは|検索で「実体」を区別する考え方

エンティティは、人物・組織・製品・場所・概念など、ほかと区別して扱える対象を指す言葉です。エンティティSEOはGoogleの公式な順位要因名ではありませんが、会社名や著者名、サービス名が何を指すかを明確にし、読者と検索エンジンの混同を減らす実務を指して使われます。
GoogleはKnowledge Graphを、人・場所・物と、その事実や関係を扱う仕組みとして説明しています。SEOやLLMOでエンティティを整える目的は、順位やAI回答への引用を保証することではなく、公式情報の主体・出所・関係を確認しやすくすることです。GoogleのKnowledge Graph解説
エンティティの定義|人物・組織・製品・概念を区別する
実務では、次のような対象をエンティティとして扱います。重要なのは分類の数ではなく、同名の別人物・別会社・別サービスと取り違えないよう、正式名称、公式URL、説明、関係者を一貫して示すことです。
- 人物:著者・代表者・専門家(所属、役割、経歴)
- 組織:企業・団体・ブランド(法人名、公式ドメイン、所在地)
- 製品・サービス:サービス名・対象者・提供主体・料金や仕様
- 概念:専門用語・技術概念(定義、根拠、関連する用語)
キーワードとエンティティの違い|検索語と「誰・何か」を分けて考える
キーワード調査は、読者がどんな語で悩みを探すかを把握するために必要です。エンティティの整理は、その語が指す人物・会社・サービス・概念を明確にするために行います。両方が必要であり、どちらかだけで検索順位やAI回答への引用が決まるものではありません。

| 比較軸 | キーワードSEO | エンティティの整理 |
|---|---|---|
| 確認する問い | 読者は何を検索するか | その名称は誰・何を指すか |
| 主な施策 | 検索意図に答える本文・見出し・内部リンク | 公式情報、著者情報、構造化データ、表記の整合 |
| 見る対象 | 検索語・検索結果・ページ内容 | 名称・URL・組織・人物・サービスの関係 |
| 期待する状態 | 読者の疑問に答えられる | 同名対象との混同を減らし、出所を確認できる |
エンティティの確認方法
自社がAIや検索で「同じ会社・同じ人物」と扱われやすい状態かは、検索画面を一度見るだけでは判断できません。検索結果→公式情報→第三者情報の順で、社名・URL・事業内容がつながるかを確かめます。
確認の順番|3つの公開情報を照合して同一性を確かめる
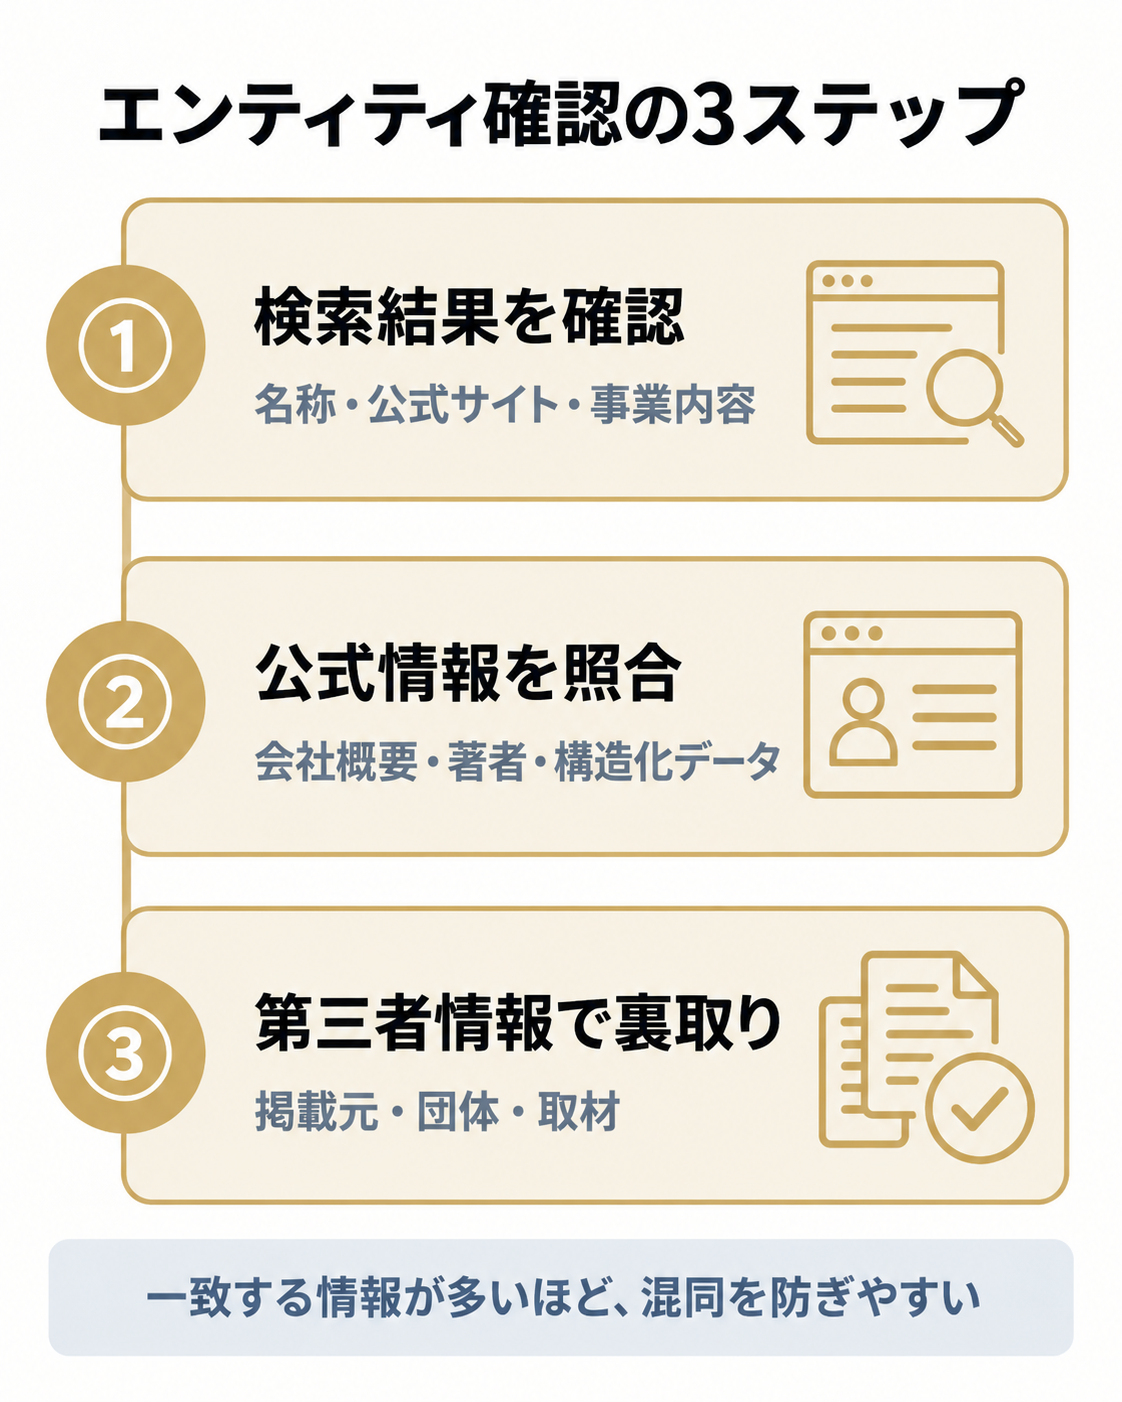
ここでの目的は、AIの内部評価を当てにいくことではありません。同名の別事業者・別人物と混同されないことがゴールです。1つでも食い違いがあれば、外部サイトを増やす前に公式サイトの表記を直してください。
| 順番 | 見る場所 | 確認する項目 | 不一致なら |
|---|---|---|---|
| 1 | 指名検索・ナレッジパネル | 名称、公式サイト、業種、所在地 | 誤った候補を記録する |
| 2 | 公式サイト・構造化データ | 法人名、代表者、URL、著者、サービス | 公式情報を基準に直す |
| 3 | 団体掲載・取材・公式プロフィール | 掲載元、URL、事業内容、人物関係 | 外部ページの訂正可否を確認する |
ナレッジパネル|表示の有無より、4項目の一致を見る
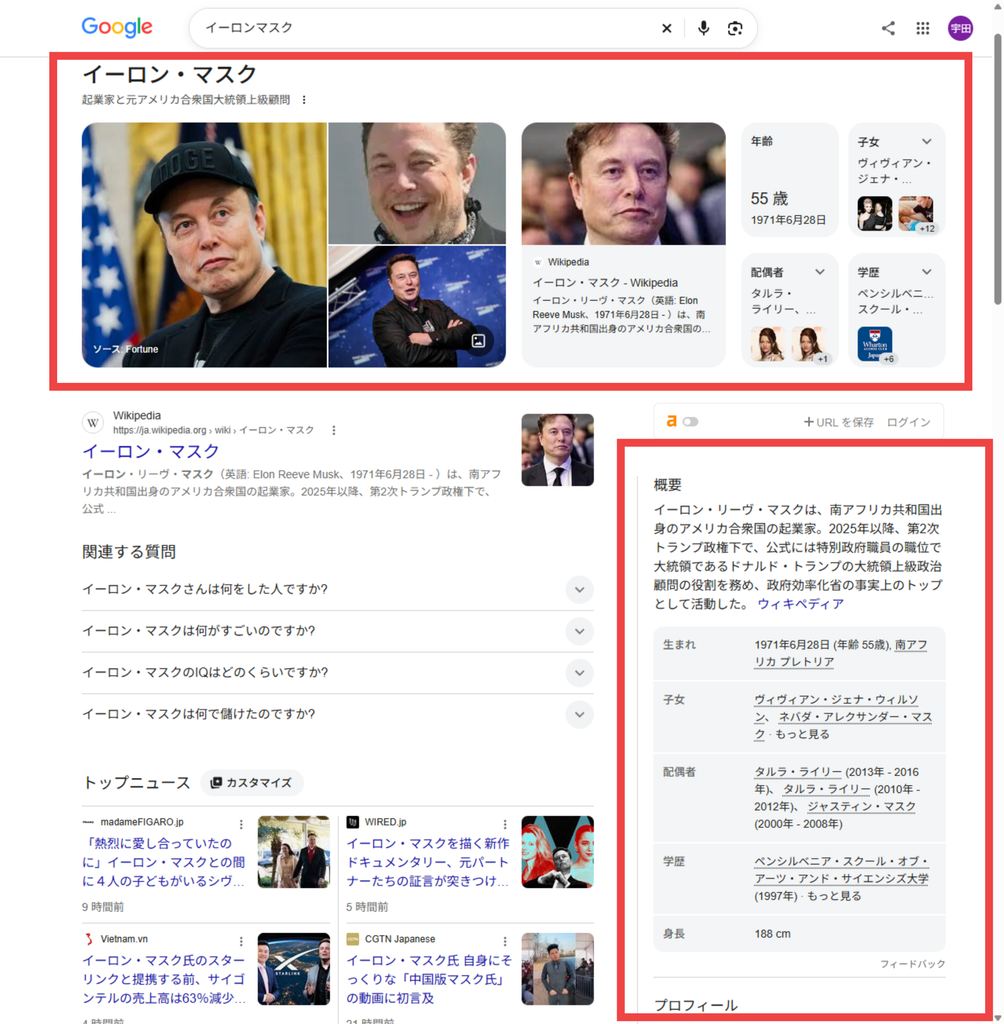
ナレッジパネルが出たら、名称・業種・公式サイト・所在地の4項目を会社概要と照合します。出ない場合も、公式ページと第三者ページの表記がそろっているかを見れば確認は進められます。誤った候補が混ざるときは、まず自社サイトの会社概要・著者情報・連絡先を正し、次に運営できる外部プロフィールを同じ表記へそろえましょう。
Googleトレンド|「検索された事実」と「同一性」を混同しない
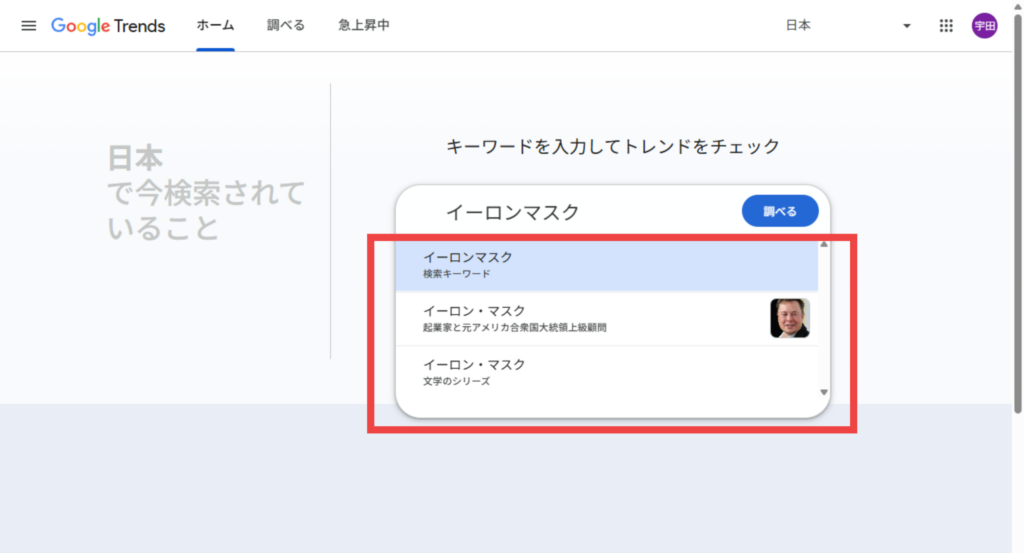
Google トレンドでは、法人格の有無、略称、商品名を分けて比較します。検索が伸びた時期に、PR・取材・イベントなどの理由があるかも確認してください。ただし、検索量があることは同一性の証明ではありません。「検索されている」ことと「誰の情報か」は別の確認項目です。
識別子|公式URLを基点に、組織と著者を結び付ける
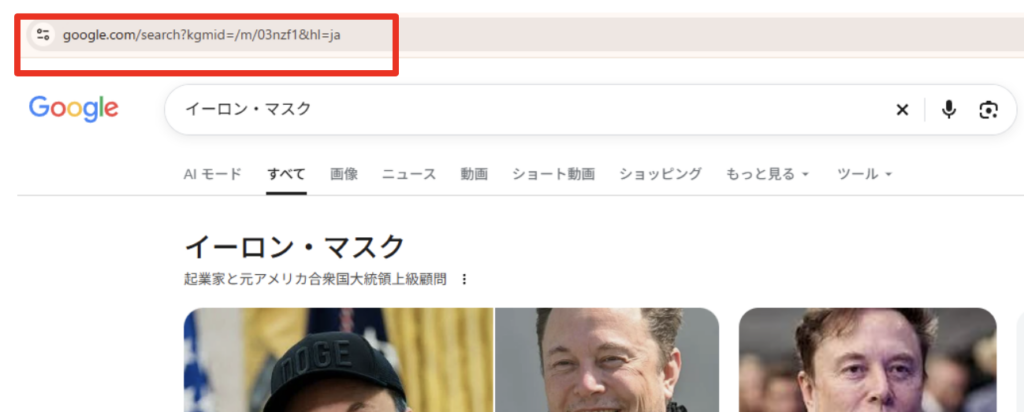
基準点は公式ドメインです。会社概要、サービスページ、著者ページ、公式SNSを相互にたどれる状態にします。構造化データの Organization と Person には、画面上に実際に表示している名称・URL・連絡先だけを記述してください。sameAs も、運営主体を確認できる公式ページに限定します。GoogleのOrganization構造化データの説明も、組織情報を検索で理解してもらうための情報として案内しています。
特許から読み取れること|同名・類似名は文脈と複数の手掛かりで分ける
Googleの特許「Question answering using entity references in unstructured data」は、非構造化コンテンツ中の参照を、頻度や話題性などの手掛かりで順位付けして質問応答に使う実装例です。現在のGoogle検索やLLMのランキング仕様を示すものではありません。ただし、文字列が同じだけでは足りず、周辺文脈と複数の参照を突き合わせるという実務上の確認原則を考えるヒントにはなります。
確認作業では、画面キャプチャだけを残すのではなく、「確認日・検索語・一致した項目・不一致だった項目・修正担当」を一覧化すると、表記ゆれの再発を防げます。
エンティティSEOがSEO・LLMOの土台になる理由
エンティティを整えることは、SEOとLLMOの土台にはなります。ただし、GoogleやLLMのランキング・引用ロジックは公開されておらず、「最強の順位要因」「引用を決める唯一のシグナル」とは言えません。ここでは、公開情報から確認できる範囲を整理します。
検索は文字列だけでなく、対象と関係性を扱う
GoogleはKnowledge Graphを、人・場所・物に関する事実と関係を扱う仕組みとして説明しています。同名異義語を区別し、関連する情報をまとめるための考え方であり、エンティティSEOではこの「誰・何の情報か」を公式サイト上で明確にします。GoogleのKnowledge Graph解説
Organization構造化データは、組織の曖昧さを減らす補助情報
GoogleはホームページのOrganization構造化データについて、組織の管理情報を理解し、検索結果で他組織と区別しやすくする助けになると案内しています。社名、URL、ロゴ、連絡先、該当する識別子を、ページに表示している事実と一致させます。一方でGoogleは、構造化データを使う機能が検索結果に表示されることを保証していません。Organization構造化データの公式ドキュメント
AI検索でも、情報源をたどれる状態を作る
GoogleはAI Modeで、関連する複数の検索を並行して行う「query fan-out」を使うと説明しています。また、Web上の高品質なコンテンツやKnowledge Graphなど複数の情報源を組み合わせます。これは特定の企業がAI回答に載る条件を示すものではありませんが、公式情報・著者情報・第三者情報の出所をたどれるようにする意義はあります。GoogleのAI Mode解説
LLMOエンティティの登録・強化に必要な要素・施策
「LLMOエンティティを登録する」単一の申請先はありません。先にやるべきことは、公式サイトの事実をそろえ、その事実を外部プロフィールと第三者情報で矛盾なく確認できる状態にすることです。登録先の数を増やしても、社名やURLが食い違えば逆効果になり得ます。
優先順位|登録先を増やすより、検証可能な事実を順にそろえる
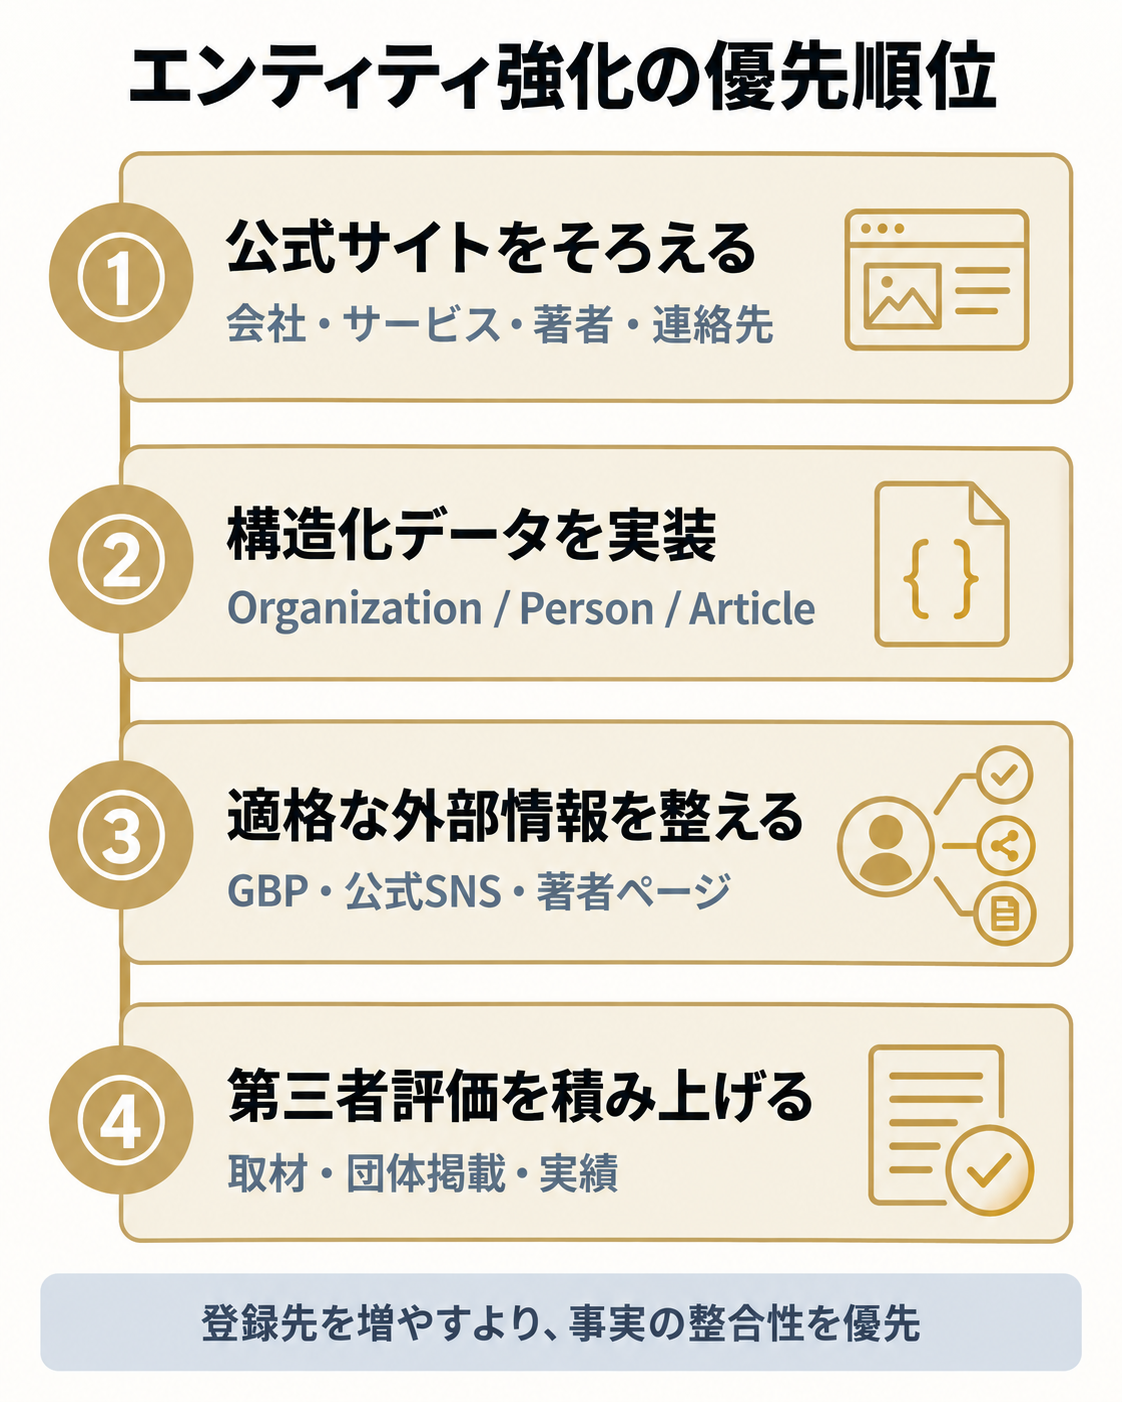
- 最初:公式サイトの会社概要、サービス内容、著者・監修者、問い合わせ先を一致させる
- 次:構造化データと、実在する公式プロフィールをつなぐ
- 最後:第三者が確認できる取材、専門団体の掲載、実績を積み上げる
| 優先順位 | まず行うこと | 確認できたら次へ | やらないこと |
|---|---|---|---|
| 1 | 公式サイト・著者ページを更新 | 全ページで名称・URL・連絡先が一致 | ページごとに異なる肩書・URLを残す |
| 2 | 構造化データを実装 | 表示内容とOrganization/Person/Articleが一致 | 画面にない実績や人物関係を記述する |
| 3 | 適格な外部プロフィールを更新 | 運営主体・公式URL・事業内容が一致 | 実態のない掲載先を量産する |
| 4 | 第三者評価を積み上げる | 掲載理由と文脈を第三者が確認できる | 広告を独立評価のように見せる |
公式サイトと著者情報|一次情報の基準点を作る
まず、会社概要と各サービスページで、法人名・所在地・連絡先・提供範囲・責任者を一致させます。専門的な記事には、執筆者または監修者の氏名、経歴、担当領域、所属、更新日を明示し、その人物ページから関連する公式プロフィールへ到達できるようにします。実績は、対象・期間・役割・公開可否を確認したものだけを載せ、匿名の数字だけで権威性を演出しないことが重要です。
構造化データschema.org|Organization・Person・Articleを表示内容と一致させる
組織ページには Organization、人物ページには Person、記事ページには Article を、ページ上で読者に見える内容と一致する形で実装します。Googleは、Organizationの構造化データを組織情報の理解に役立てるためのものとして説明し、Articleの構造化データでは記事情報をGoogle検索で理解しやすくする手順を公開しています。実装後はリッチリザルトテスト等で文法を確認し、社名変更・著者変更の際にも更新します。構造化データだけで掲載順位やAIの引用が決まるわけではありません。
Googleビジネスプロフィール|来店・訪問型など対象事業だけを正確に登録する
Googleビジネスプロフィールは、顧客と対面する事業所、または顧客のもとへ訪問する事業に適したプロフィールです。対象になる場合は、事業名、カテゴリ、営業時間、電話番号、Webサイト、サービス提供地域を公式サイトとそろえ、変更時に更新します。オンラインのみの事業や実態のない住所での登録は避けてください。詳細はGoogle ビジネス プロフィールのガイドラインで確認できます。
Amazon著者ページ・外部プロフィール|実在する活動を公式URLで接続する
Amazon著者ページは、実際に著作を公開している著者であれば、著作と著者情報を結ぶ補助的なプロフィールになります。著作がない企業・人物がLLMO目的だけで作る施策ではありません。業界団体、登壇先、寄稿先、公式SNSなども同様に、実際の活動と運営主体が確認できるページだけを公式サイトから案内します。外部ページの量ではなく、名称・URL・経歴が公式情報と矛盾しないことを優先してください。
Wikipedia|登録施策にせず、特筆性と中立性を先に満たす
Wikipediaは企業が自社を登録してLLMOを強化するための媒体ではありません。記事の作成・編集には、独立した信頼できる情報源による十分な言及、検証可能性、中立的な記述などが求められます。条件を満たさない段階で作成を急ぐより、一次情報の整備と、実態に基づく第三者評価を積み上げる方が先です。基準はWikipediaの特筆性に関する方針を確認してください。
第三者評価と継続観測|事実を増やし、成果は別に測る
取材、専門団体への掲載、登壇、利用者のレビューなどは、第三者が誰で、どの事実を確認したかが分かる形で残します。対価を伴う広告・タイアップは、その性質を明示し、独立した編集評価と混同させません。施策後は、表記ゆれの減少、指名検索のクエリ、AI経由セッション、商談・問い合わせを分けて観測します。AI上の表示は変動するため、特定の回答画面だけを成果指標にせず、事業KPIとのつながりで評価します。
自社の公開情報にどこまで差分があるか、優先順位を付けたい方へ。株式会社Mesutでは、エンティティの同一性確認、構造化データ、外部掲載、コンバージョンまでを切り分けて、必要な作業だけをご提案します。AI引用や順位を保証するものではありませんが、実行内容と確認指標を明確にしたい場合はご相談ください。
ナレッジグラフ登録のメリットと進め方
Knowledge Graphは、Googleが人・場所・物などに関する事実を扱う仕組みです。ナレッジパネルはその情報を表示する形の一つで、すべての企業に表示されるものではありません。したがって「ナレッジグラフへ登録してパネルを出す」をKPIにするのではなく、正しい情報を公開・更新し、誤りがあれば修正できる状態を目指します。
ナレッジパネルは自動生成され、表示は保証されない
Googleはナレッジパネルを、Knowledge Graphの情報から自動的に生成するものと説明しています。情報源はWikipediaだけではなく、Web上の多数の情報源、オープンソース、ライセンスされたデータなどです。表示の有無を施策の合否にせず、表示された場合は名称・公式サイト・所在地などの正確性を確認しましょう。Googleのナレッジパネル解説
進め方|公式情報を更新し、検証と再クロールを行う
- 会社概要・著者ページ・連絡先を最新の事実へそろえる
- Organization/Person/Articleの構造化データを表示内容に合わせる
- Rich Results TestとURL検査で、Googleが読み取れる状態かを確認する
- 第三者プロフィールは、実在し運用できるものだけを公式URLと接続する
WikidataやWikipediaの作成を前提条件にはしません。各コミュニティの方針と特筆性を満たさない自己登録は、エンティティ施策として推奨できません。
LLMOエンティティ強化の効果測定|5つのKPI
エンティティSEOの成果は、ナレッジパネルの表示だけでは測れません。検索での可視性、情報の整合性、事業成果を分け、施策前後の変化を同じ条件で観測します。AI回答の表示は変動するため、単発のスクリーンショットだけで成果判定しないことが大切です。
追跡する5つの指標
| 指標 | 確認方法 | 読み方 |
|---|---|---|
| 表記ゆれ | 公式サイトと主要プロフィールの照合表 | 不一致を0に近づける |
| 指名検索クエリ | Search Console | 社名・人物名・サービス名の表記を分ける |
| 対象KWの掲載順位 | 同じ国・端末・検索語で順位計測 | SEOの成果として別管理する |
| 自然検索の流入とCV | Search Console/GA4 | クリックではなく問い合わせ・商談まで確認する |
| AI経由の参照流入 | GA4の参照元・URLパラメータ | 計測できる範囲を補助指標として扱う |
観測期間|再クロールと事業サイクルに合わせる
Googleは構造化データ公開後のクロール・再インデックスに数日かかる場合があると案内しています。順位や問い合わせは競合・季節性・ページ改善など複数の要因で動くため、「何か月でナレッジパネルが安定する」といった一律の期限は置きません。公開日、変更内容、確認日を記録し、7日・28日・90日など自社の商談サイクルに合わせて比較してください。
エンティティSEOとLLMOエンティティの違い
「エンティティSEO」「LLMO」は業界で使われる便宜的な呼び方で、Googleが順位要因として定義した公式用語ではありません。両者を別施策として切り離すより、検索とAIのどちらでも情報の出所・主体・関係性を明確にする共通基盤として扱うのが実務的です。
共通するのは、読者と検索エンジンが確認できる事実
SEOでは、検索意図に答える本文、内部リンク、クロール可能なページ、適切な構造化データが重要です。LLMOでも、誰が述べた情報か、一次情報へたどれるか、更新されているかを読み手が確認できる状態が基盤になります。いずれもAI引用や上位表示を保証するものではありません。
優先順位は、SEOの基本を崩さないこと
まずは検索意図に合う本文、タイトル、見出し、内部リンク、インデックス可能性を整えます。そのうえで会社・著者・サービスの情報をそろえ、構造化データと外部プロフィールを確認します。「LLMO向け」と称して根拠のない掲載や構造化データを増やす前に、読者が検証できるページを作ることを優先してください。
エンティティSEOとLLMOに関するよくある質問(FAQ)
Q. エンティティSEOをすれば検索順位は上がりますか?
A. 保証はできません。エンティティ情報の整備は、組織・人物・サービスを区別しやすくする補助になりますが、順位は検索意図への適合、コンテンツ品質、技術要件、競合状況など複数の要因で決まります。
Q. schema.orgを実装すればAIに引用されますか?
A. 引用は保証されません。構造化データはGoogleにページや組織情報を理解してもらう補助です。画面上の事実と一致させ、検証ツールで確認したうえで、本文の一次情報・著者情報・更新日も整えます。
Q. WikipediaやWikidataは必須ですか?
A. 必須ではありません。Googleは多数のWeb情報源、オープンソース、ライセンスデータを扱うと説明しています。各サービスの方針を満たさない自己登録は避け、まず公式サイトの事実を整えてください。
Q. 中小企業は何から始めればよいですか?
A. 会社概要、サービス、著者、連絡先の表記をそろえ、公式URLを基点に構造化データと実在するプロフィールを確認します。その後、取材・事例・専門団体など、実際の活動に基づく第三者情報を増やします。
関連記事
まとめ|エンティティSEOは情報の整合性から始める
エンティティSEOは、会社・人物・製品・概念を、読者と検索エンジンが取り違えないように整理する取り組みです。構造化データ、ナレッジパネル、第三者情報は手段であり、順位やAI引用の保証ではありません。
- 公式サイトを情報の基準点にし、社名・URL・著者・サービスをそろえる
- Organizationなどの構造化データは、画面にある事実と一致させて検証する
- 外部プロフィールや第三者言及は、実在・運用・出所を確認できるものだけを使う
- 順位、Search Console、自然検索CV、計測可能なAI参照流入を分けて観測する
関連記事